- AI
- 物体検出
- WACV 2027
- Core ML
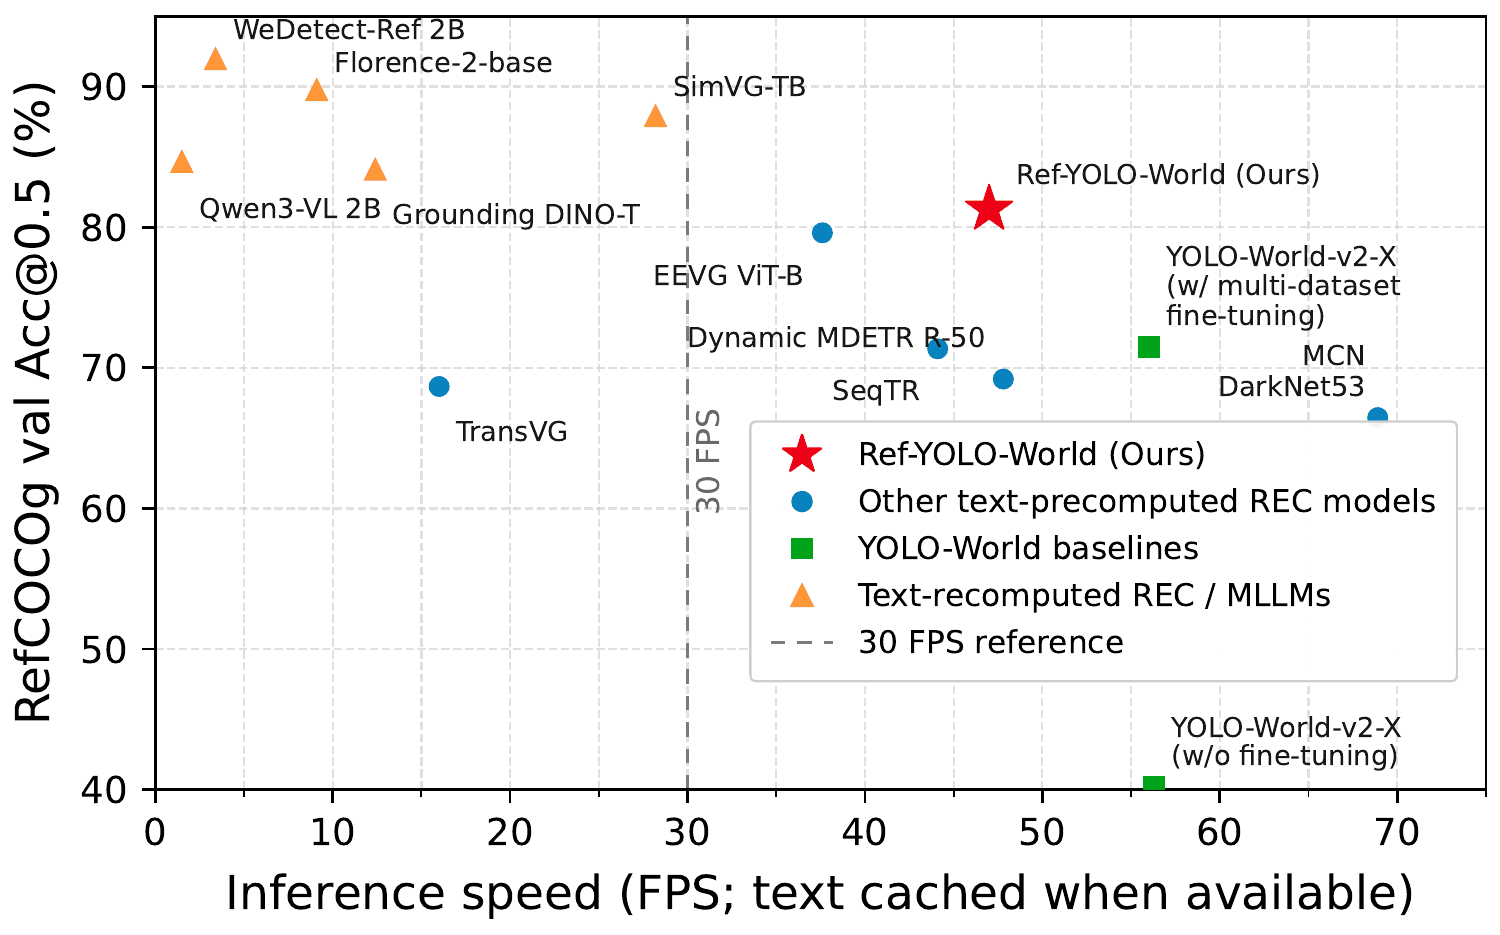
スマートフォンなどのエッジ端末上で、「サングラスをかけてベージュのコートを着た男性」のような文章から、画像内の対象物体を1つ検出する参照表現理解(REC)モデルを高速かつ高性能に動かすための研究です。 提案手法は、RefCOCOg valで[email protected] 81.29%、iPhone 15 Proで15.73 FPSの動作を両立しました。
以前MIRU 2025でポスター発表したDy-YOLO-Worldの課題をベースにした研究で、その続きとして卒業論文で取り組んでいる内容になります。
本研究は学部4年次に国際会議 WACV 2027(採択率: 33.7%、ICORE A)のApplication Trackにフルペーパーが採択されました。

背景と手法
近年の精度の高い参照表現理解モデルは、Qwen3-VLやChatGPTなどのMLLMを活用しています。これらの手法をエッジ端末内で動かすことは難しく、また画像と文章の両方を毎フレーム処理するため計算量が大きく、リアルタイムで動かすのが難しい点が課題でした。
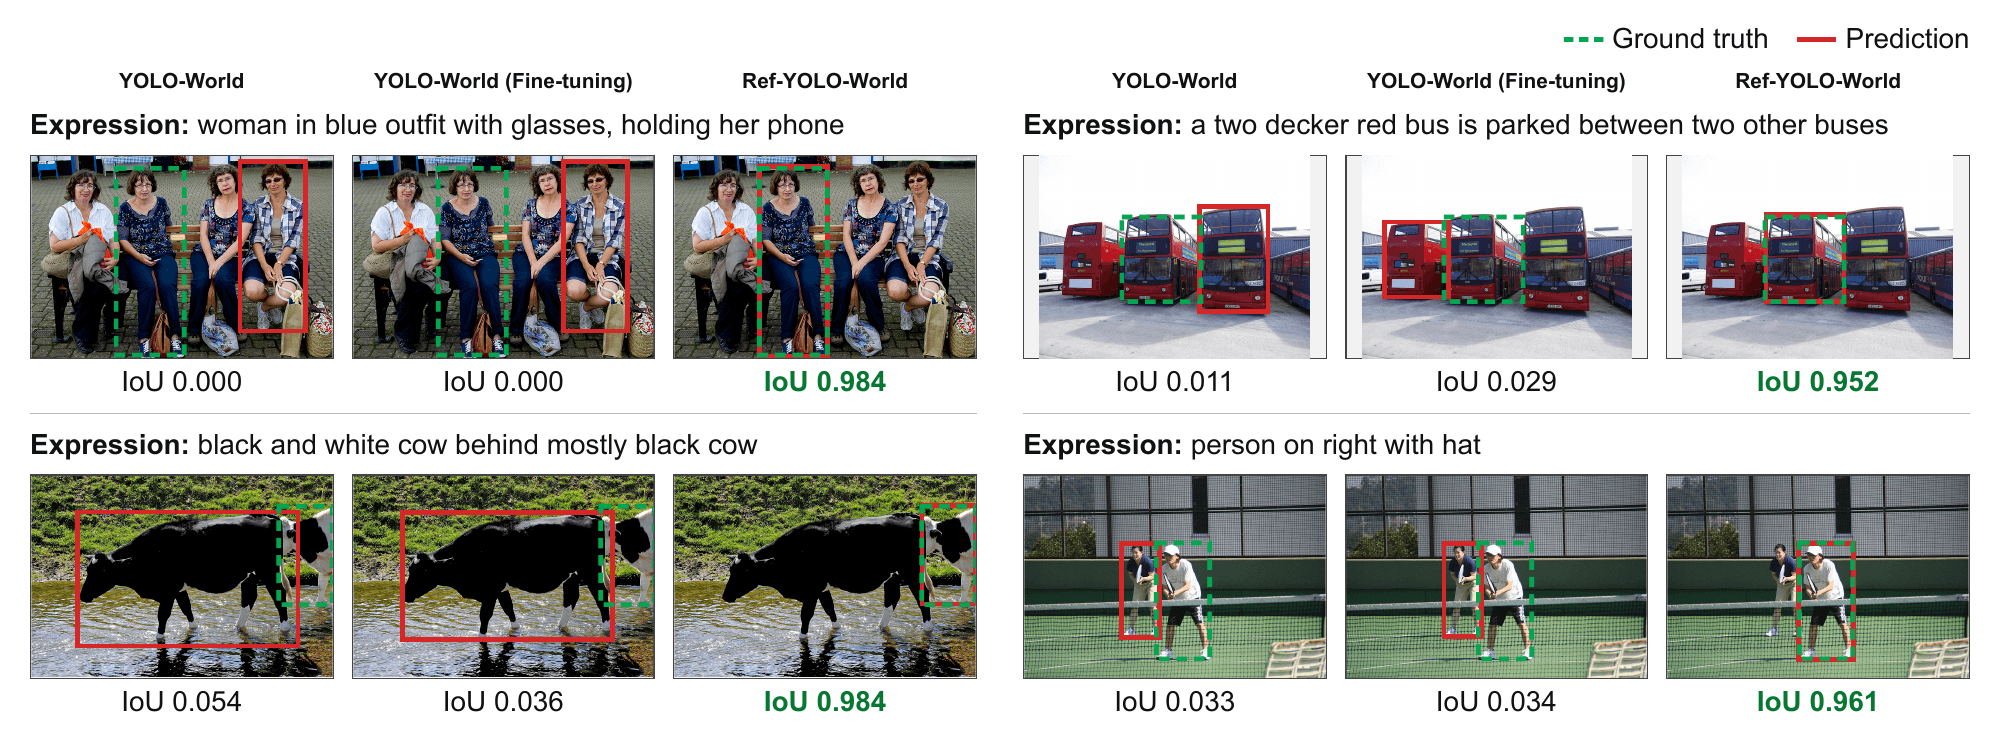
高速なオープンボキャブラリー物体検出モデルのYOLO-Worldは、テキストを一度だけエンコードして使い回せます。ただし文章全体を1つのベクトルにまとめるため、「左の」「サングラスをかけた」といった単語ごとの手がかりを検出に反映しにくいという課題がありました。
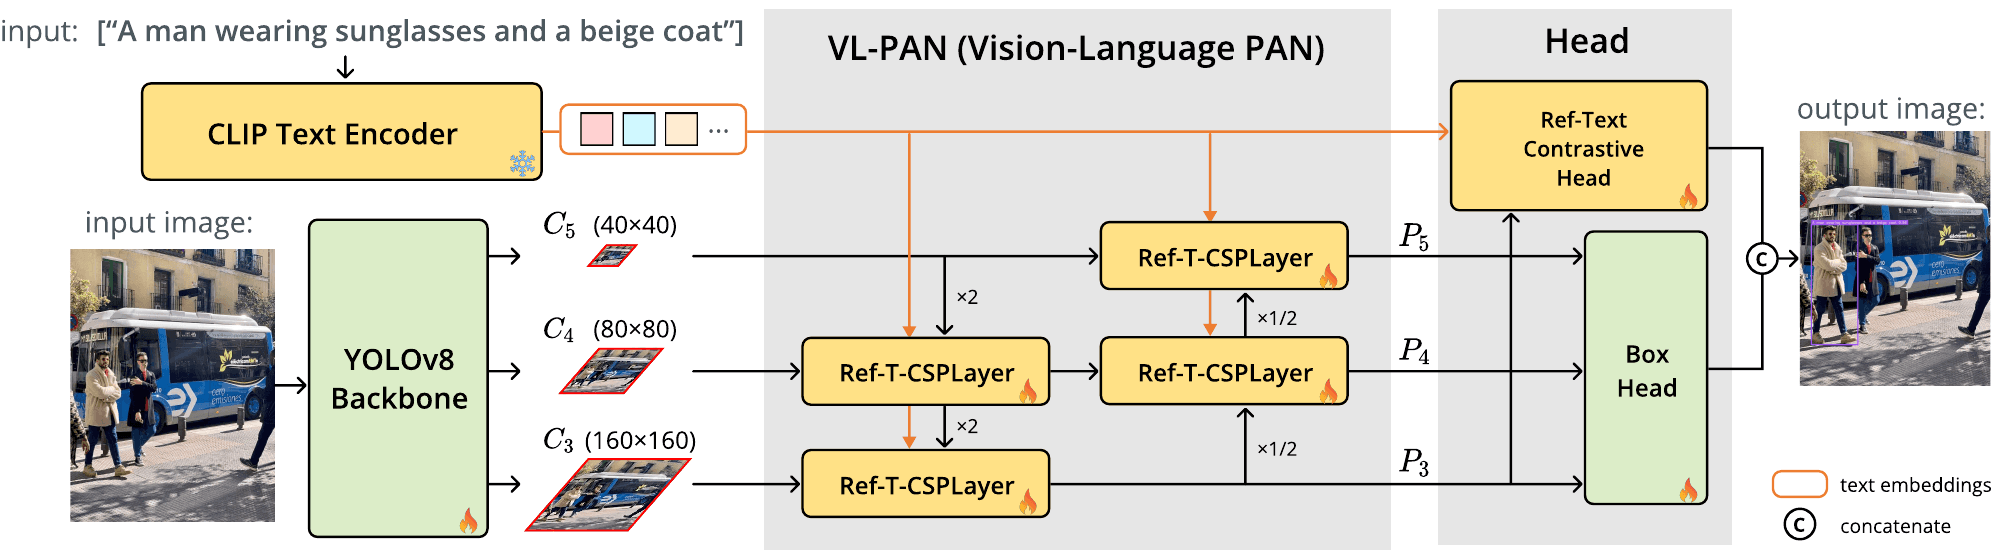
本研究では、YOLO-Worldの速さを保ったまま、文章の単語(トークン)ごとの特徴を検出に使えるRef-YOLO-Worldを提案しました。テキスト側の処理は画像から独立させ、追加したクロスアテンションのキー・バリューの射影まで含めて、文章1つにつき1回だけ計算してキャッシュします。
文章の各トークンの特徴は、次の2つの軽量なモジュールによって取り込んでいます。
- Ref-T-CSPLayer:Neckの各段で、全トークンの特徴をクロスアテンションで参照(「左」「奥」など位置を表す言葉のため、2次元の位置埋め込みも追加)
- Ref-Text Contrastive Head:領域とテキストのスコアを計算する前に、全トークンの文脈を各領域の特徴に追加


デモ
Core MLに変換した提案手法のモデルをiPad Proで動かした様子です。動画の再生と枠の描画も同時に行っているため、この動画では3〜4 FPSほどになっています。
ブラウザ上で動くONNXのデモとしてHugging Face Spacesにも公開しています。 https://huggingface.co/spaces/sakusaku3939/Ref-YOLO-World
リンク
- 論文 (PDF)
ref-yolo-world.pdf - GitHub
https://github.com/sakusaku3939/Ref-YOLO-World - デモ (Hugging Face Spaces)
https://huggingface.co/spaces/sakusaku3939/Ref-YOLO-World - モデル (Hugging Face)
https://huggingface.co/sakusaku3939/Ref-YOLO-World